乌拉特后旗评奖方法,暴露出一大缺陷!改进后结果将大不同!
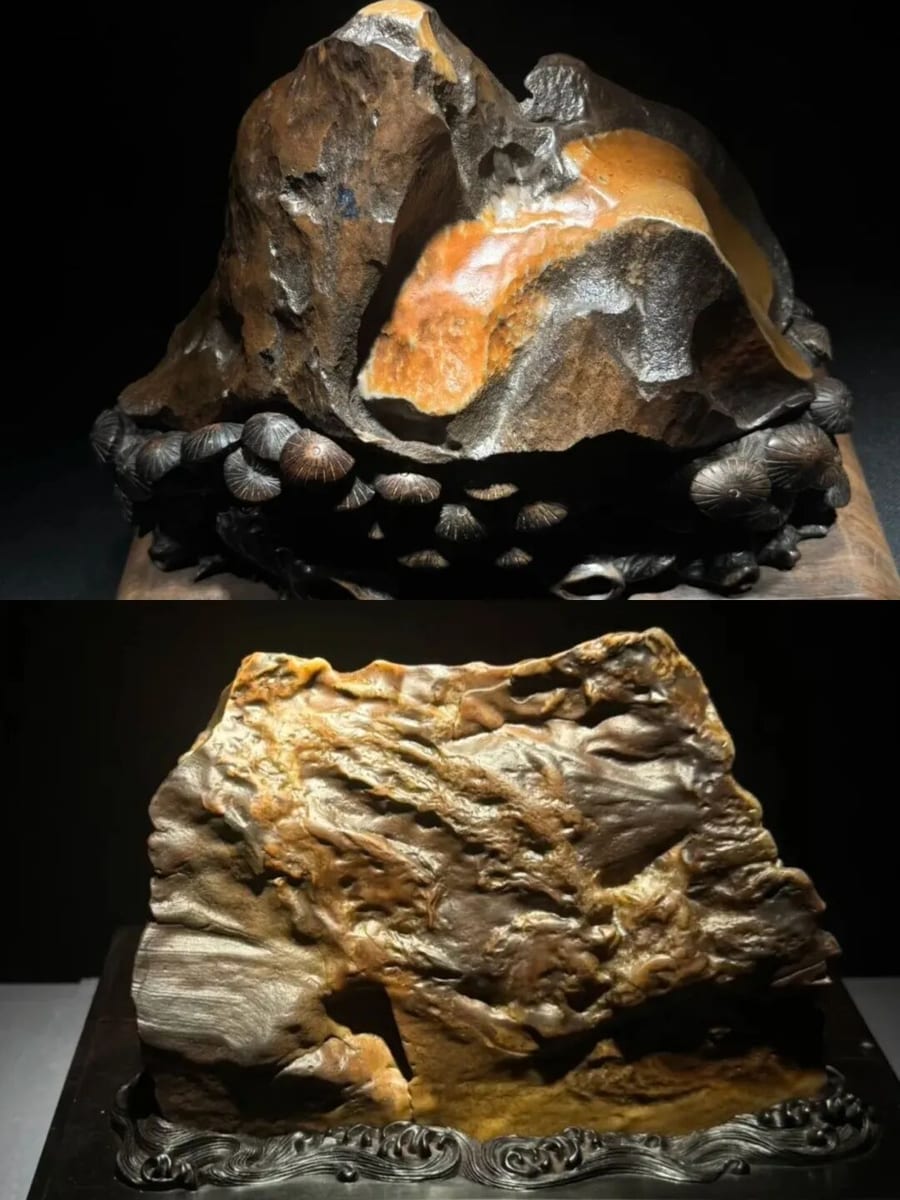
乌拉特后旗的石展今年在“规范化”上下功夫,成绩卓著!吸引来大量极少露面的精品参展,但是评选出来的结果却很难令人满意。
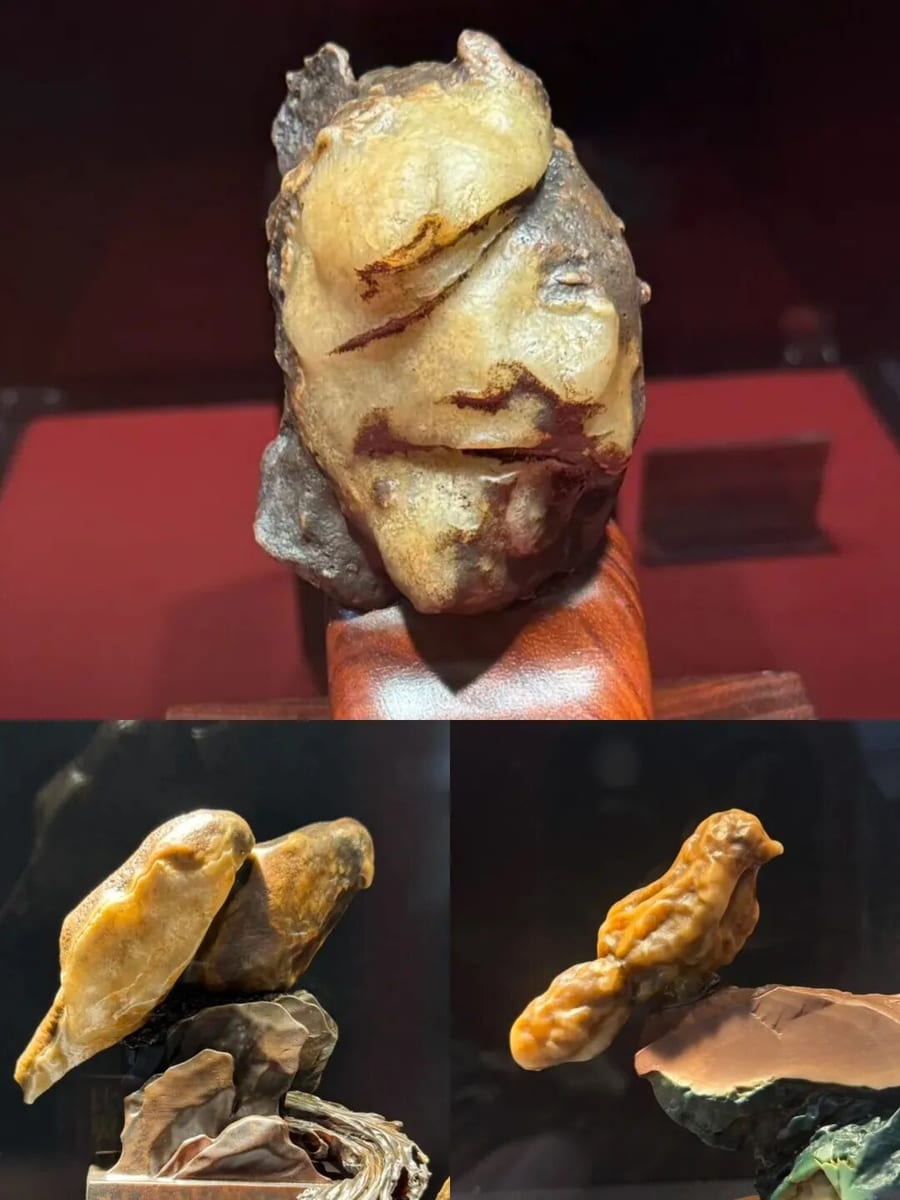
因为银奖里有不少藏品不输金奖,铜奖里也有不少能冲击金奖和银奖的奇石藏品。甚至没得奖的那些石头里,照样有不少非常惹眼的!石友就问了,明明很严格,很公正的在评选了,感觉好像对结果不满意的人更多了。问题出在哪?
因为 参展奇石品质分布 发布巨大变化, 传统的方法不能胜任。十多年来,参展的藏品通常是一小部分精品奇石带着一大部分比较普通的石头展览。把金奖,银奖,铜奖三张纸交给评委去填写。最后的结果和大多数评委的结果几乎一致。
但是这次不同,参展的380多方精品奇石, 精品更多,普品更少,老式的评奖方法让一个优秀的参评奇石在金奖,银奖,铜奖里都能得到比较好的成绩,但是还可能什么奖都拿不到,同时,另一个石头,既在评委们金奖名单里,也在银奖里,还可能在铜奖里。
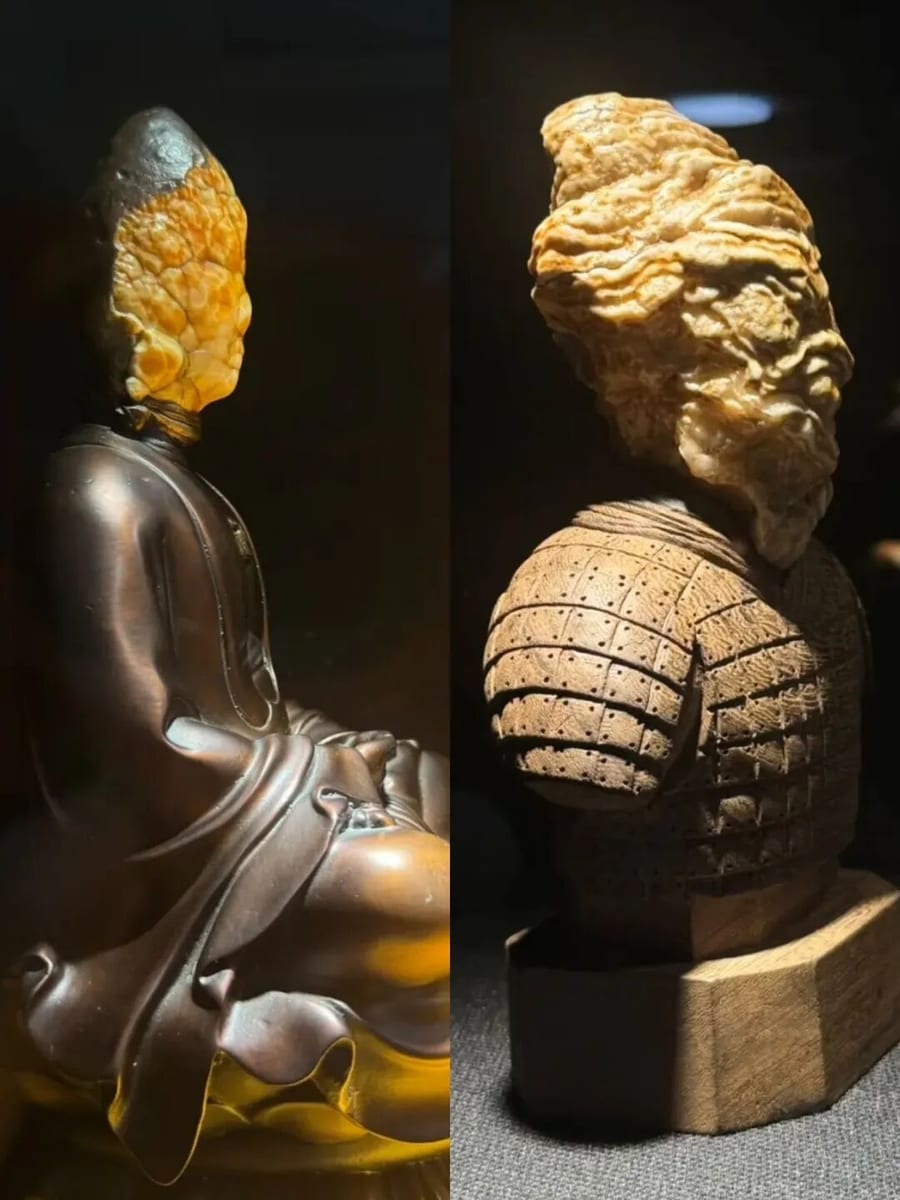
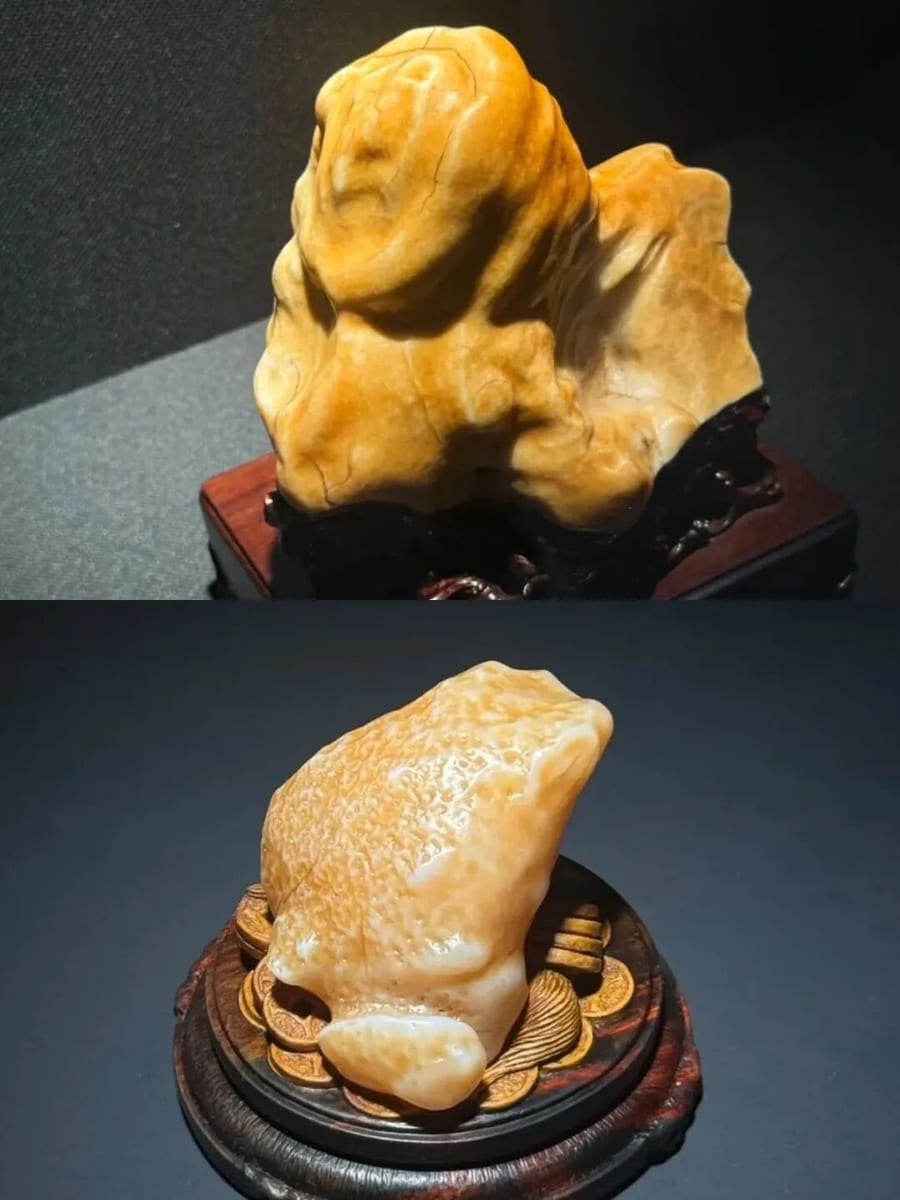
即, 评委给出的数据利用率不高,最终的金奖名单和每一个评委填写的表单都初、出入很大。 只有恰巧的重合,才会一不小心成为了金奖!本次评奖最大的受益者应该是“小鸡破壳”,因为“乌拉特后旗”+“小鸡出壳”是所有评委大脑里的 共同认识,“小鸡破壳”因为相关性,就很容易成为评委的共同选择。
21个评委每人写15个金奖奇石到手里的表格中,最大数据量是315,最小数据量是15。自然状况下, 金奖表单里的参展奇石可能有近100个。不考虑并列只有15个成为金奖。剩下80来个被看好成为“金奖”的石头,就很尴尬。虽然会把金奖票加给银奖票。但是给它给了金奖票的评委,又把银奖位置留给了其他石头。1:1的金变银最多只能算个补丁。 那有没有更好的方法能让评选更有科学性。 还真有,并且更容易理解和执行!兼顾科学和感情。感情是什么?是让冷门石头也被注意到。每个评委,为每一方石头打分,分数只有1分,2分,3分。最后,每一个石头都会有自己的总分,取前15方,作为金奖。取金奖之后的30个石头,作为银奖。银奖之后再接下来的45方,作为铜奖。清晰,明了,不浪费评委的每一个数据,并且公平公正性更高,适用性也更高,真正做到不冷落每一个石头,不浪费每一分。这样会不会让评委太累了?不会啊,评委本来每一个石头都要看过去。老方法里,普通一点的时候,评委一眼扫过了都不会看第二眼,新方法里,评委扫一眼,也得给它打个分,至少也得给1分。
主办方肯定在担心,数据量那么大,现场人工统计很耗时耗力。其实,评委规范标记和填写后,能够自动录入系统,并立马呈现每个石头的总得票数。以前没有专门开发的系统做不了这个事儿。 但是现在有AI,把规范的数据上传给AI,它能给你准确的统计结果。现场人工只需要抽查验证正确性,完成复检即可。更少的人力,更准确的结果。更科学的评选。不难吧?话虽如此,有没有可能乌拉特后旗再精彩也是昙花一现。奇石展会本就是人情世故,没有人情,可能石展都办不下去。
本文首发自《奇石故事汇》公众平台,原创作者淘石圈;文中图片引用自网络,部分由 AI 辅助生成,转载请注明出处。